如何用两张照片做一支 AI 丧尸视频
两张照片怎样选出能讲故事的一对,四个分镜如何做得有电影感,成片后又该怎样为 TikTok、Reels 做后期——一份完整的 AI 丧尸视频流程。
 AI Zombie Video 团队
AI 丧尸视频是一部由两张照片和一套固定四镜头结构拼成的短片:第一张提供幸存者,第二张提供已经变成丧尸的那一位。中间发生什么由场景模板决定,所以您挑的这对照片,比任何设置都更能决定成片的样子。
先挑照片,再谈别的
第一张照片会被派作幸存者,第二张是已经变了的那位:两张图一起交给模型,它要在四个分镜里让这两张脸始终认得出。请在五个维度上把两张照片对齐:
- 构图一致。 两张照片保持同样的机位距离和同样的高度。人脸在画面里的占比接近,片子就会一直跟着同一组人,而不是在两个构图之间跳。
- 光线一致。 同一天同一时段的两张,胜过一张晴天、一张暗室。光线不一致时,模型会把力气花在重新打光上,而脸部变形往往就发生在那一刻。
- 脸部清楚。 正面、无遮挡、合焦、眼睛睁开。墨镜、手挡住脸、运动模糊,都会让可供参考的信息变少。
- 背景干净。 杂乱的房间和人群会跟主体抢注意力,模型跟不上的细节就会被抹成扭曲。
- 分辨率与画幅接近。 两张都清晰、裁剪比例接近,结果最干净。要发竖屏,就拍竖的。
顺序和照片本身同样重要:第一张被派作幸存者,第二张是已经变了的那位,换过来枪就握错了那只手。所以把最清楚、最镇定的一张给第一格——它就是举枪那张脸,带着眼泪;把经得起更冷解读的一张给第二格,因为那张特写正是以它为底。
两张照片对不上怎么办
完美的成对照片很少见。把两张都裁到更紧的胸上景别,优先选头部大小与光线最接近的那组,而不是各自最抓眼的那两张。
选故事模式,而不是写提示词
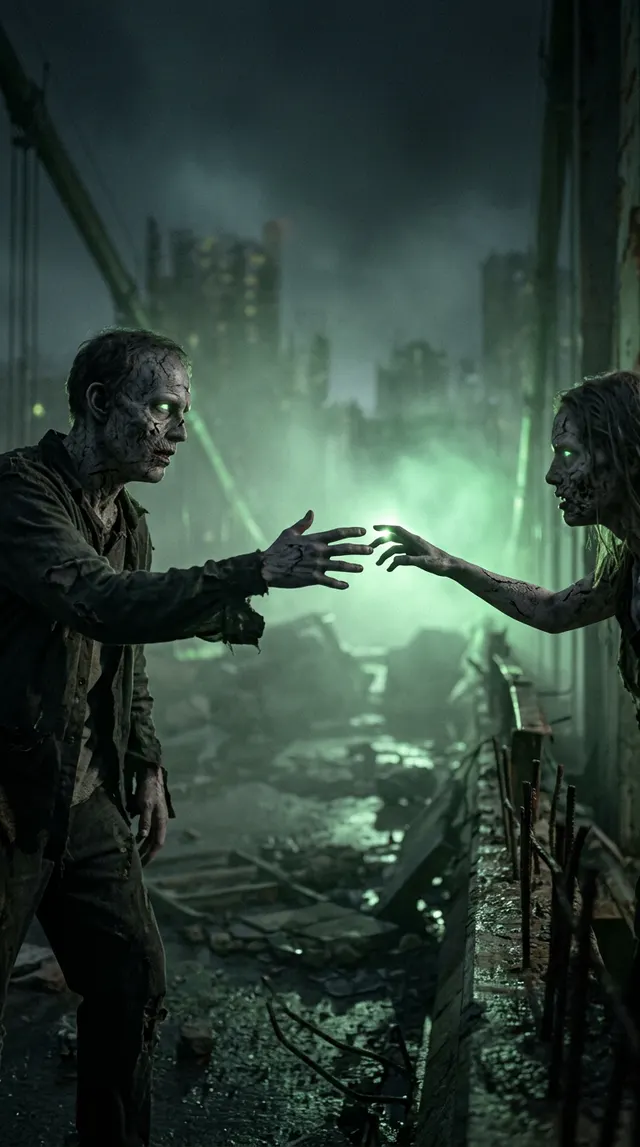
这里没有提示词输入框,而且这是刻意的。AI Zombie Video 会为四种故事模式在服务端套用场景模板,所以模型拿到的是调好的电影化指令,而不是您临时想到的那句话。四种模式是丧尸情侣、丧尸宠物、丧尸好友和万圣节派对——它们共用同一套分镜:举枪的人终究没能扣下扳机,张开双臂,而那记扑跃硬切成一个拥抱。每种模式有自己的节奏、调色与配乐。
每条片子固定 15 秒、720p,音频随画面一并生成,下载的文件没有水印。一条片子 20 积分,积分包是一次性购买、没有订阅,积分也不会过期。动手前先到示例墙扫一眼哪种模式贴您那对照片,比坐下来推想快得多。
让四个分镜看起来像电影
表情包和短片之间的差别在于克制。
- 一个抉择,不是一场面斗。 枪缓缓垂落、脱手而出,就是全片的转折;两个人扭打在一起只会读作故障,一个人做出选择才读作调度。
- 一次环境切换。 昏暗木屋硬切到落日下的开阔麦田——一个"世界已经变了"的明白信号,就够了。
- 一个身体特征。 特写里灰白的皮肤、浑浊的双眼、龇出的牙齿。您要的血腥越少,观众越肯信那仍是他们认得出的人。
- 前后各一套调色,而不是一个滤镜。 前十秒冷调去饱和,后五秒金色透亮——正是这层反差让拥抱落地。
- 声音要用,不要盖。 配乐随画面一起生成,高光时刻是按它排的,所以让原声承担那一瞬。
这一路上的模型如今都原生处理音频和两个端点。字节跳动 Seedance 的说明页写明时长可在 4 到 15 秒之间挑选、原生生成音频、并支持首帧/末帧输入——两张照片变成一条片子靠的正是这套能力。Google Veo 的文档描述的是单条约 8 秒、720p/1080p/4K、原生音频、支持首帧与末帧,并有 16:9 与 9:16 两种比例。
渲染之后,为信息流做后期
一条片子大约 3 分钟。您可以关掉标签页——渲染照样完成——失败的渲染会自动把积分退回。拿到文件后,把它当素材来剪:
- 剪掉片头。 信息流里的观众决定得很快,第一个可见动作之前的一切都该删掉。
- 收在一张脸上。 收尾那帧是循环里反复出现的一帧,而它本来就是您的第二张照片,所以挑那张您能连看两遍的。
- 两种音频都试。 在原声上叠一段热门配乐常常能让帖子跑得更远,但请从生成的那版声音开始。
- 文字避开界面区。 字幕放在画面中段,别被各平台的按钮和简介盖住。
- 别放大分辨率。 把 720p 重新编码成更大的数字只增加体积,不增加细节。
从生成页开始:上传两张照片、挑好故事都不需要登录,只有渲染那一步需要,单张照片支持到 10 MB。要多出几条,积分包从一条片到六十条片都有,最大那档能把单片压到 $2.10;三片装就足够把一种模式跑两遍,再留下更好的那条。